Principais destaques
- Claude entrega mais refinamento: testes práticos indicam que o Opus 5.5 produz jogos e aplicações mais completos, com maior riqueza visual e estrutural.
- Gemini aposta em velocidade e preço: o Argon consegue criar protótipos funcionais em poucos minutos, por uma fração do custo do concorrente.
- Benchmarks não contam a história toda: pontuações próximas em testes sintéticos não garantem a mesma qualidade na construção de softwares reais.
Escolher uma inteligência artificial para programar parece simples quando basta olhar os rankings. O problema começa quando você pede que ela construa um aplicativo completo, desenvolva um jogo ou transforme uma ideia em um produto pronto para uso.
É nesse cenário que o Gemini 4 Argon, do Google, e o Claude Opus 5.5, da Anthropic, mostram diferenças importantes.
Os dois apresentam resultados competitivos em benchmarks, mas os testes práticos descritos na análise de Luis Chavez-Mattos apontam para uma divisão clara: um modelo favorece a velocidade e a economia; o outro entrega resultados mais elaborados.
E essa diferença pode determinar quanto tempo você gastará corrigindo o código depois.
🏁 Dois modelos, duas prioridades
O Gemini 4 Argon se destaca pela capacidade de transformar instruções em protótipos funcionais rapidamente. Já o Claude Opus 5.5 demonstra maior consistência na construção de projetos que exigem detalhes, organização e acabamento.
| Critério | Gemini 4 Argon | Claude Opus 5.5 |
|---|---|---|
| Velocidade | Grande vantagem | Mais lento nos testes relatados |
| Custo por tarefa | Mais baixo | Mais alto |
| Prototipagem | Excelente proposta de uso | Capaz, mas menos econômico |
| Acabamento visual | Funcional, porém irregular | Mais detalhado |
| Projetos complexos | Pode exigir mais ajustes | Resultados mais completos nos testes |
| Melhor aplicação | Validar ideias rapidamente | Desenvolver uma base mais refinada |
A diferença não significa que o Argon seja incapaz de criar bons softwares. Significa que, nos exemplos apresentados, ele exigiu concessões maiores em acabamento e completude.
💸 Cinco minutos contra vinte: o preço da velocidade
Um dos testes mais ilustrativos envolveu a criação de um jogo 3D com temática de pombos.
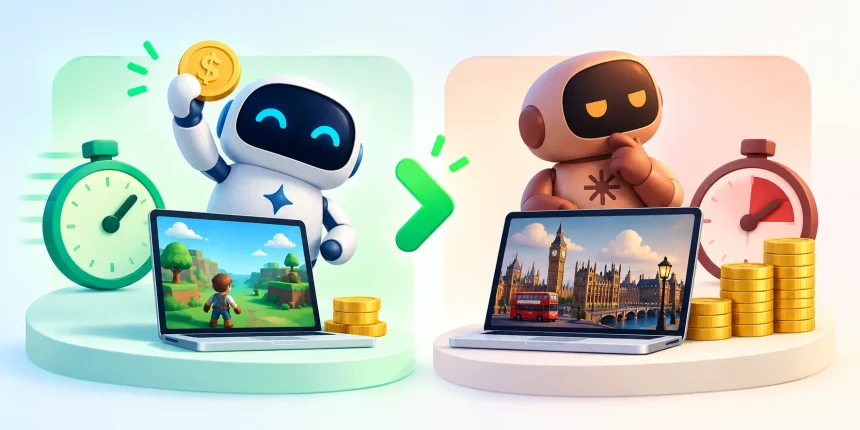
O Gemini 4 Argon levou aproximadamente cinco minutos e custou cerca de US$ 0,43. O resultado tinha modelos tridimensionais aceitáveis e sombras básicas, mas o mapa era vazio e pouco desenvolvido.
O Claude Opus 5.5 levou cerca de vinte minutos, com custo próximo de US$ 3. Em contrapartida, entregou um ambiente mais elaborado, com edifícios, personagens não jogáveis e elementos urbanos que ajudavam a compor um cenário reconhecível de Londres.
O custo de criar o mesmo tipo de protótipo
Gemini 4 Argon
US$ 0,43
5 minutos
Claude Opus 5.5
US$ 3,00
20 minutos
O Argon foi cerca de 7 vezes mais barato
Considerando os valores aproximados relatados nesse teste específico, não uma tarifa universal.
🔎 O detalhe que muda a conta: produzir código mais rapidamente não significa necessariamente concluir um projeto mais cedo. Se o protótipo exigir horas de correções, melhorias visuais e reorganização, parte da economia inicial pode desaparecer.
Por outro lado, para testar uma mecânica de jogo, validar uma interface ou descobrir se uma ideia é viável, gastar centavos em vez de alguns dólares pode fazer muita diferença.
🎮 Quando a tarefa fica complexa, o cenário muda
Outro teste levou o Gemini 4 Argon ao Antigravity, ambiente de desenvolvimento com agentes de IA do Google.
A missão era construir um jogo de mineração multiplayer inspirado em Roblox. Nesse tipo de projeto, o modelo precisa lidar com várias etapas, manter a coerência entre componentes e corrigir problemas ao longo da execução.
O trabalho durou mais de uma hora e consumiu a cota disponível antes da conclusão. Outro modelo precisou assumir a tarefa para finalizar o projeto.
O resultado era funcional em seus aspectos essenciais, mas ainda parecia um rascunho. Os jogadores apareciam diretamente em um carrinho de mineração, sem uma etapa inicial de preparação, e a experiência geral carecia de refinamento.
💡 Fazer funcionar é apenas a primeira etapa. Em projetos complexos, a diferença está em transformar um conjunto de funcionalidades em uma experiência coesa, bem estruturada e pronta para evoluir.
Isso ajuda a explicar por que o Claude Opus 5.5 saiu na frente nos testes práticos descritos no artigo. Não se trata apenas de gerar mais linhas de código, mas de entregar uma construção mais próxima do resultado esperado.
🧪 E os benchmarks? Eles ainda servem para alguma coisa?
Sim, mas precisam ser interpretados com cuidado.
Nos índices agregados da Artificial Analysis mencionados pelo artigo, o Gemini 4 Argon ficou aproximadamente cinco pontos atrás do Claude Opus 5.5. A diferença sugere uma distância mensurável, mas não necessariamente enorme, entre os modelos.
O Argon também apresentou uma relação entre desempenho e custo mais favorável.
O problema é que um índice agregado combina diferentes avaliações e não reproduz integralmente as dificuldades de desenvolver uma aplicação real. Um modelo pode obter uma pontuação elevada em tarefas padronizadas e ainda apresentar dificuldades para manter consistência visual, estruturar um projeto grande ou resolver problemas inesperados.
🧩 O risco dos benchmarks: quando os modelos são otimizados para avaliações conhecidas, uma pontuação excelente pode não se traduzir na mesma qualidade em situações novas. Essa preocupação, conhecida em parte como benchmaxing, aparece no debate descrito pela análise.
Por isso, rankings são úteis para selecionar candidatos, mas testes com tarefas próximas do seu trabalho real são mais relevantes para decidir qual modelo contratar ou utilizar.
🧱 Há uma vantagem inesperada do Gemini
Apesar das limitações nos jogos, o Argon apresentou um resultado interessante em outra categoria: a geração de modelos tridimensionais para impressão 3D.
Em um teste com uma única fotografia de referência, o modelo produziu um busto reconhecível e razoavelmente fiel à imagem.
Esse exemplo sugere que a avaliação de uma IA para programação não deve se limitar à construção de sites e aplicativos. Modelagem, visualização, prototipagem física e outras tarefas técnicas também podem revelar competências que os benchmarks tradicionais não capturam.
A ressalva é importante: o artigo não apresenta uma comparação equivalente com o Claude nessa tarefa. Portanto, não é possível afirmar, com base nesse teste isolado, que o Argon seja superior ao concorrente em modelagem 3D.
🤖 E o Muse Wonder, da Meta?
A comparação acontece em um mercado no qual novos modelos estão se aproximando em pontuações agregadas, mas continuam apresentando diferenças na prática.
Segundo o artigo, o Muse Wonder, da Meta, alcançou resultados próximos aos do Opus 5.5 em alguns índices. Nos testes de geração de jogos, porém, ficou atrás dos dois concorrentes.
Em um jogo de beisebol desenvolvido por código, as mecânicas e os controles de câmera funcionavam, mas os elementos visuais eram consideravelmente mais simples.
A Meta também lançou o Muse Spark Open, uma versão com pesos abertos descrita no material como seu modelo de pesos abertos mais capaz desenvolvido por um laboratório norte-americano. Sua arquitetura exige uma quantidade substancial de memória para execução local, mesmo com técnicas de compressão.
O caso reforça um ponto: modelos com pontuações semelhantes não são necessariamente intercambiáveis. A escolha depende do que você quer construir e de quanto trabalho adicional está disposto a assumir.
💰 Quanto custa o Gemini 4 Argon?
O preço inicial divulgado no artigo foi de US$ 2 por milhão de tokens de entrada e US$ 10 por milhão de tokens de saída.
Esses valores faziam parte de uma condição promocional, com previsão de aproximadamente dobrar após uma janela limitada que terminaria no fim de novembro de 2026.
Isso significa que a vantagem econômica pode mudar. Comparar apenas o preço por token também é insuficiente: o volume consumido, as tentativas necessárias, o tempo de execução e o custo de corrigir o resultado influenciam o gasto final.
Para equipes que desenvolvem software continuamente, o indicador mais útil é o custo por tarefa concluída com qualidade aceitável, e não apenas o preço nominal da API.
🛠️ Qual dos dois faz mais sentido para o seu projeto?
A escolha depende da etapa de desenvolvimento.

Gemini 4 Argon: para experimentar
Ideal para validar conceitos, gerar primeiras versões, testar funcionalidades, explorar alternativas e descartar rapidamente ideias que não funcionam.

Claude Opus 5.5: para refinar
Faz mais sentido quando a prioridade é uma implementação detalhada, uma estrutura mais completa e menos distância entre a primeira entrega e o resultado desejado.
🚀 A estratégia mais interessante pode ser combinar os dois.
Uma abordagem possível é usar o Argon para produzir uma primeira versão econômica e testar a viabilidade da ideia. Depois, o Claude pode assumir o refinamento, a expansão das funcionalidades e os ajustes de acabamento.
Esse fluxo não garante que o segundo modelo consiga corrigir automaticamente todos os problemas do primeiro. A qualidade da documentação, dos testes e das instruções de transição também será determinante.
Ainda assim, é uma maneira racional de aproveitar a velocidade de um modelo e a capacidade de acabamento do outro.
O verdadeiro teste é o software que continua funcionando
A comparação mostra por que escolher uma IA apenas pelo ranking pode ser um erro. O modelo mais barato pode ser o melhor para explorar dez ideias antes de investir em uma. O mais caro pode compensar quando cada entrega exige mais consistência e menos retrabalho.
A decisão também depende do que significa estar pronto: um protótipo que demonstra uma ideia, um aplicativo utilizável ou um produto que precisa suportar manutenção e evolução.
No fim, a pergunta não é apenas qual modelo escreve o melhor código. É qual deles entrega o resultado necessário com o menor custo total de desenvolvimento.