Principais destaques
- Dois novos aceleradores: Google apresenta o TPU 8tx e o TPU 8i Max, ampliando para quatro as configurações de chips de oitava geração lançadas em 2026.
- Segurança durante o processamento: TPU 8tx protege dados sensíveis e modelos de IA diretamente no hardware, com foco em governos e empresas regulamentadas.
- Memória em outra escala: TPU 8i Max dobra a capacidade computacional, a SRAM e a largura de banda de memória em relação ao TPU 8i.
A corrida pela inteligência artificial está entrando em uma nova fase. Não basta mais construir modelos maiores ou responder a perguntas com rapidez. Agora, o desafio é manter dezenas de agentes trabalhando simultaneamente, processando grandes volumes de informações e acessando dados corporativos sem comprometer a segurança.
É nesse cenário que o Google anunciou, em 9 de novembro de 2026, duas novas configurações de seus aceleradores de inteligência artificial: TPU 8tx e TPU 8i Max.
A novidade amplia o portfólio de TPUs de oitava geração para quatro sistemas diferentes. Segundo a empresa, é a primeira vez que ela apresenta quatro configurações de TPU em um único ano.
E existe uma razão para isso: a infraestrutura necessária para executar agentes autônomos está ficando muito mais exigente.
Google quer atender a todas as etapas da IA 🤖
Os novos chips não foram desenvolvidos para substituir os modelos anteriores, mas para atender a necessidades específicas dentro do ciclo de vida da inteligência artificial.
O Google trabalha com suas TPUs para treinar e executar modelos próprios, oferecer infraestrutura aos clientes do Google Cloud e, mais recentemente, permitir que empresas instalem esses aceleradores diretamente em seus próprios data centers.
Esse mercado também está crescendo. A companhia afirma que já possui quase 100 clientes, incluindo laboratórios de IA, empresas de negociação financeira, varejistas e universidades.
🔎 O que mudou nesta geração: em vez de oferecer apenas mais capacidade de processamento, o Google está diversificando sua infraestrutura para resolver gargalos específicos, como memória, latência e proteção de informações.
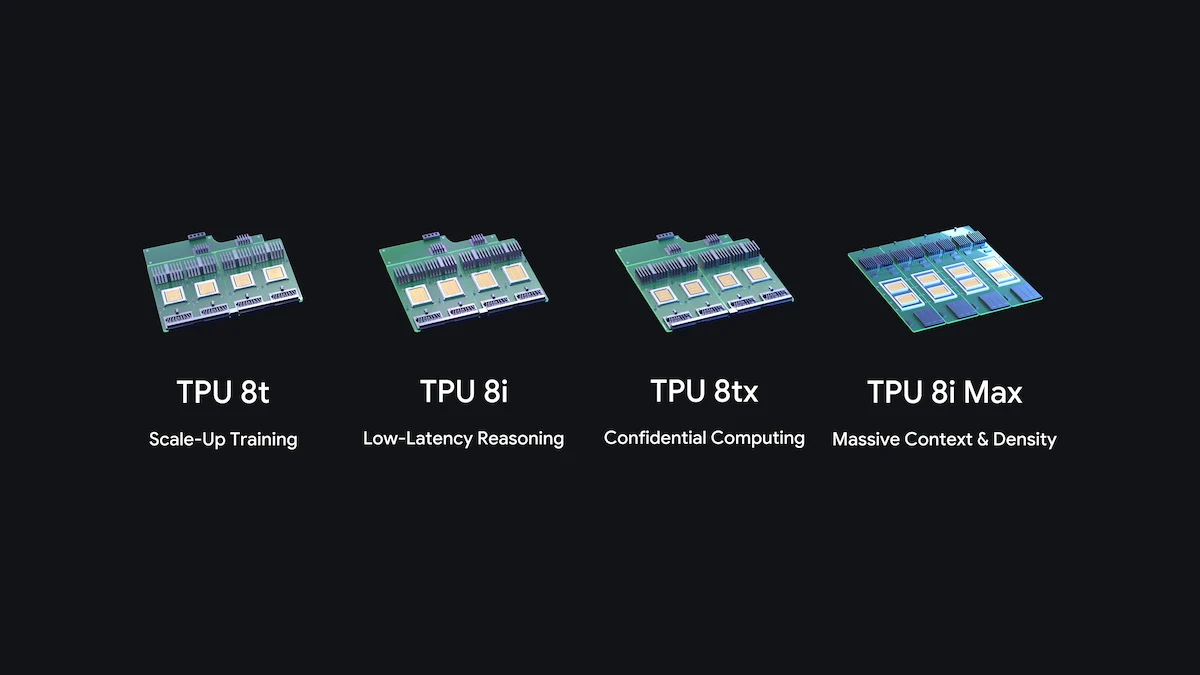
Os quatro sistemas agora têm funções distintas:
| Sistema | Principal finalidade |
|---|---|
| TPU 8t | Treinamento de grandes modelos de IA |
| TPU 8i | Raciocínio com baixa latência |
| TPU 8tx | Computação confidencial e treinamento em pequena escala |
| TPU 8i Max | Grandes janelas de contexto e maior densidade computacional |
TPU 8tx: segurança mesmo durante o processamento 🔐
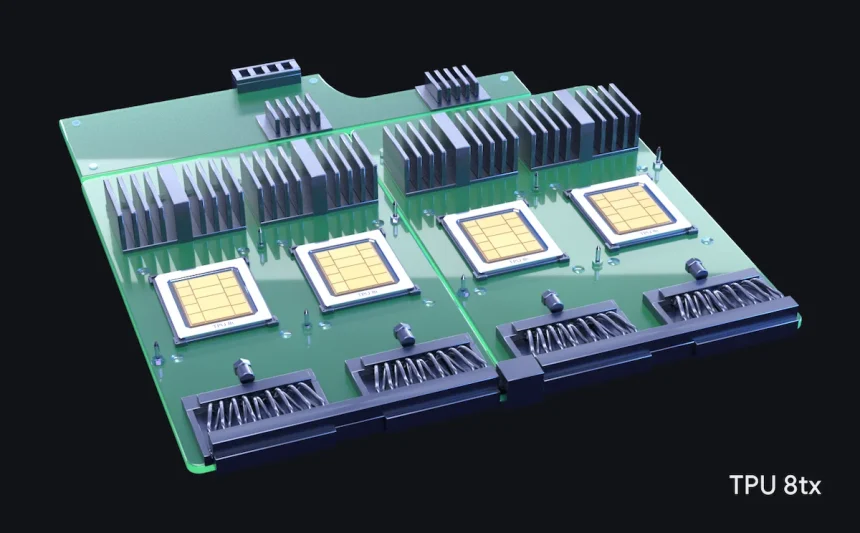
Um dos anúncios mais interessantes é o TPU 8tx, desenvolvido especialmente para governos e organizações que trabalham com informações altamente sensíveis.
Existe um problema importante na segurança da computação tradicional: criptografar dados quando estão armazenados ou sendo transmitidos não é suficiente. Durante o processamento, eles normalmente precisam ser descriptografados na memória.
É justamente nesse intervalo que o TPU 8tx pretende fazer a diferença.
🛡️ Proteção diretamente no hardware: o sistema incorpora mecanismos de segurança na própria infraestrutura, mantendo dados confidenciais e pesos dos modelos protegidos e isolados mesmo enquanto estão sendo utilizados.
O equipamento utiliza o mesmo silício do TPU 8t, combinado com processadores AMD personalizados para os sistemas hospedeiros.
Outro destaque está na rede Boardfly, desenvolvida para oferecer comunicação de baixa latência entre os componentes.
Segundo o Google, o TPU 8tx consegue entregar latência duas vezes menor em comparação com o TPU 8t, com penalidade de desempenho praticamente nula.
Treinar e executar modelos sem separar os ambientes
O TPU 8tx também foi projetado para permitir que organizações trabalhem com treinamento e inferência simultaneamente.
Isso abre espaço para diferentes aplicações:
• Ajustar modelos de IA utilizando dados privados das empresas.
• Destilar modelos maiores em versões menores e mais eficientes.
• Treinar agentes autônomos por meio de aprendizado por reforço.
• Executar modelos proprietários sem precisar transferir informações sensíveis entre clusters diferentes.
💡 A proposta é aproximar treinamento, personalização e execução de modelos em um ambiente protegido, reduzindo a necessidade de movimentar informações confidenciais entre diferentes infraestruturas.
Para setores financeiros, governos e empresas com exigências rigorosas de conformidade, essa combinação pode ser particularmente importante.
TPU 8i Max quer resolver um dos maiores gargalos da IA 🧠
O segundo lançamento ataca outro problema: a memória.
Imagine dezenas de agentes de inteligência artificial trabalhando juntos para analisar uma base de código inteira, revisar documentos extensos ou processar horas de vídeo simultaneamente.
Nessas situações, não basta ter processadores rápidos. Eles precisam receber informações na velocidade necessária para continuar trabalhando.
Quando a memória não acompanha a capacidade computacional, o desempenho fica limitado.
⚡ Mais capacidade para grandes contextos: o TPU 8i Max foi desenvolvido para aumentar a capacidade de processamento e memória de maneira proporcional.
Em comparação com o TPU 8i convencional, o novo sistema oferece:
- 2 vezes mais capacidade computacional.
- 2 vezes mais SRAM, memória integrada de alta velocidade.
- 2 vezes mais largura de banda de HBM, memória de alta largura de banda.
Na prática, isso significa que os aceleradores conseguem trabalhar com volumes maiores de informações disponíveis, reduzindo a possibilidade de interrupções provocadas por limitações de memória.
Mais processamento no mesmo espaço
Outro detalhe importante está no aproveitamento físico dos data centers.
O TPU 8i Max consegue acomodar o dobro de silício dentro da estrutura de rack existente, segundo o Google.
Isso permite aumentar a densidade computacional por metro quadrado e por watt consumido.
📊 O impacto vai além do chip: em uma infraestrutura de IA, espaço físico, consumo energético e capacidade de processamento precisam evoluir juntos. Aumentar a quantidade de aceleradores sem considerar esses fatores pode elevar significativamente os custos operacionais.
O que já ofereciam os TPU 8t e 8i?
Os dois novos sistemas complementam tecnologias anunciadas anteriormente, durante o Google Cloud Next, em abril de 2026.
Na ocasião, a empresa apresentou o TPU 8t, voltado ao treinamento de grandes modelos fundacionais, e o TPU 8i, desenvolvido para tarefas de raciocínio e inferência.
Segundo os números divulgados pelo Google, o TPU 8t oferece desempenho de treinamento até 2,7 vezes superior ao das gerações anteriores.
Já o TPU 8i apresenta uma relação preço/desempenho de inferência 80% melhor.
⚙️ Dois conceitos diferentes:
- Goodput: o TPU 8t foi projetado para maximizar a quantidade de trabalho útil realizado por watt de energia consumido.
- Baixa latência: o TPU 8i prioriza a redução dos atrasos de comunicação entre chips, chegando a diminuir esses tempos em até 50% em comparação com a geração anterior, segundo a empresa.
O resultado é uma arquitetura que procura atender tanto ao treinamento de modelos gigantescos quanto à execução de sistemas que precisam responder rapidamente.
Google também quer facilitar o acesso às TPUs
A expansão do hardware vem acompanhada de mudanças na estratégia de software.
A empresa também citou seus anúncios recentes relacionados ao PyTorch, incluindo a abertura do TorchTPU, iniciativa que permite executar PyTorch nativamente em TPUs.
A intenção é reduzir as barreiras para desenvolvedores que desejam utilizar os aceleradores do Google sem depender exclusivamente de ferramentas ou fluxos de trabalho proprietários.
🗣 A visão da empresa: Amin Vahdat, diretor de tecnologia e vice-presidente sênior de IA e infraestrutura do Google, afirmou que a mudança da computação em escala humana para a escala de agentes exige aceleradores capazes de raciocinar sobre janelas de contexto muito maiores.
Ele também destacou a demanda de clientes altamente regulamentados por recursos especializados de criptografia para determinadas cargas de trabalho.
A estratégia combina silício personalizado, infraestrutura modular e uma pilha de software mais aberta.
A próxima disputa da IA será sobre infraestrutura
O anúncio revela uma mudança importante na indústria.
Durante muito tempo, a disputa entre gigantes da tecnologia esteve concentrada no tamanho dos modelos, na quantidade de parâmetros e na capacidade de processamento. Agora, a eficiência para executar agentes autônomos começa a ganhar protagonismo.
Isso exige mais do que GPUs ou aceleradores cada vez mais rápidos. É necessário combinar memória, comunicação entre chips, segurança, eficiência energética e capacidade de processamento.
O Google está tentando cobrir essas necessidades com quatro configurações especializadas, em vez de apostar em um único acelerador para todas as aplicações.
E existe uma questão interessante nessa estratégia: à medida que os agentes passam a trabalhar por horas, acessar grandes bases de dados e executar tarefas em sequência, a infraestrutura que os sustenta pode se tornar tão estratégica quanto os próprios modelos de inteligência artificial.
Afinal, na era dos agentes, não basta ter uma IA inteligente. É preciso garantir que ela tenha memória, segurança e capacidade para continuar trabalhando.